Valor esperado em apostas: quanto custa decidir sem dados?
Um modelo reproduzível para comparar probabilidade, preço, risco e tamanho da entrada em apostas esportivas — sem confundir cenário calculado com promessa de lucro.
Por Equipe de pesquisa Odd Boa
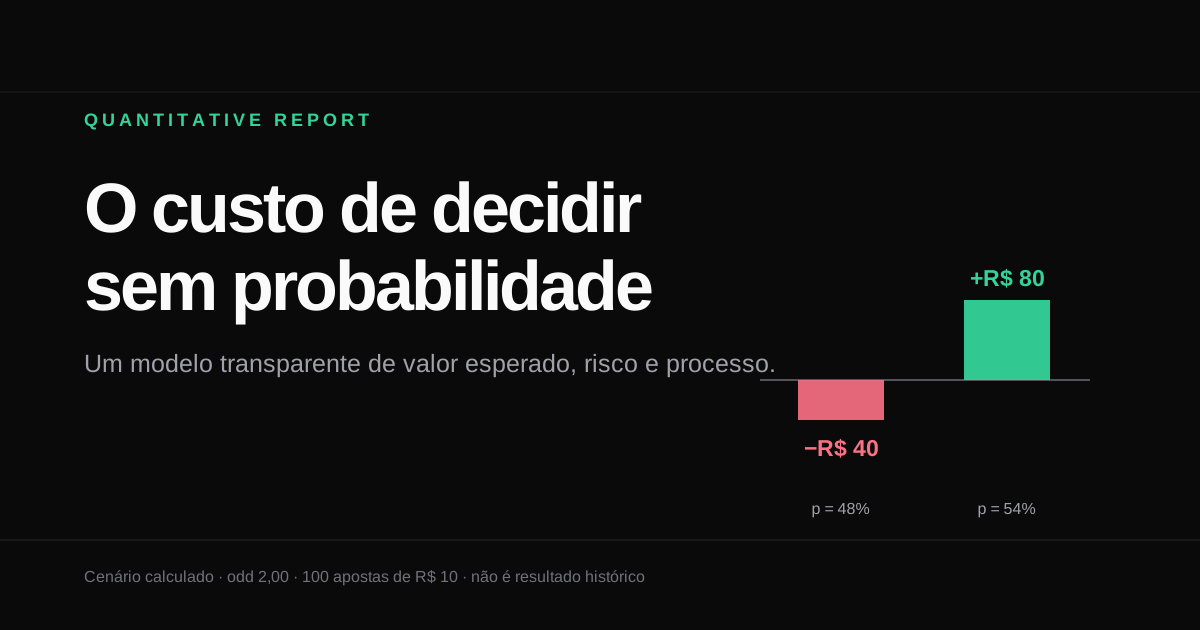
Uma aposta não é uma previsão binária. Ela é uma troca entre uma probabilidade incerta e um preço. O resultado de um jogo pode ser vitória ou derrota; a qualidade da decisão depende de algo anterior: o preço oferecido compensava o risco que você estava assumindo?
Este report aplica um modelo simples a uma sequência de apostas. Ele mede como uma diferença pequena na probabilidade estimada muda o resultado esperado e como uma decisão emocional pode aumentar a exposição sem melhorar a qualidade da informação. O modelo não promete lucro, não recomenda uma entrada e não transforma uma estimativa em certeza.
O guia Análise de apostas esportivas: como avaliar odds, probabilidade e risco apresenta o processo geral; este texto se concentra na decomposição quantitativa do preço e do risco.
O mercado brasileiro em números
Antes do modelo, vale separar escala de evidência. O Estudo Especial nº 119/2024 do Banco Central analisou transferências Pix para empresas identificadas como operadoras de jogos e apostas e classificou seus próprios resultados como estimativas preliminares, sujeitas às premissas e às limitações da base.
No período analisado, de janeiro a agosto de 2024, o estudo estimou aproximadamente R$ 20,8 bilhões por mês em transferências recebidas por empresas associadas a jogos de azar e apostas e cerca de 24 milhões de pessoas físicas com ao menos uma transferência. A análise estimou ainda que aproximadamente 15% do valor apostado ficava retido pelas empresas, embora ressalvasse que o cálculo não capturava perfeitamente todos os canais de pagamento.
Esses números ajudam a dimensionar o mercado. Eles não dizem que uma pessoa específica perde 15%, não medem o retorno de uma estratégia e não provam que usar dados gera lucro. São dados de mercado, não um benchmark de performance individual.
A pesquisa brasileira da CVM com a FGV, publicada em 2025, oferece outra camada: um experimento com 968 respostas válidas — a notícia institucional reporta 970 respostas válidas em seu resumo — que mediu reflexão cognitiva, excesso de confiança, literacia financeira e o efeito de um estímulo de aposta sobre decisões financeiras. O desenho ajuda a estudar o contexto da decisão; também não deve ser convertido em uma taxa universal de perdas em apostas.
Uma análise quantitativa separa essas quatro categorias:
- Fato observado: número publicado por uma fonte identificável.
- Cálculo: resultado obtido ao aplicar uma fórmula a premissas declaradas.
- Cenário: simulação usada para testar sensibilidade.
- Desempenho: resultado real de uma base de apostas, que precisa ser coletada e auditada separadamente.
Misturar essas quatro categorias é uma forma rápida de produzir um número que parece autoritário, mas não é verificável.
O que o valor esperado mede
Considere uma odd decimal o e uma probabilidade estimada p. A fórmula de valor esperado por unidade apostada é:
EV = (p × o) − 1
Se a odd for 2,00, a probabilidade de equilíbrio é:
p de equilíbrio = 1 ÷ 2,00 = 50%
Uma estimativa de 48% produz:
EV = (0,48 × 2,00) − 1 = −0,04
Ou seja, a perda esperada é de 4 centavos por real apostado, antes de impostos, limites, erros de execução e qualquer custo adicional. Uma estimativa de 54% na mesma odd produz:
EV = (0,54 × 2,00) − 1 = +0,08
O resultado esperado é de 8 centavos por real apostado. Isso não significa que a próxima aposta vencerá. Significa que, se a probabilidade estiver bem calibrada e o preço se repetir, a média dos resultados tende a ser diferente ao longo de muitas repetições.
A margem do mercado
Em um mercado com várias seleções, some as probabilidades implícitas de todas as odds:
overround = (1 ÷ odd 1) + (1 ÷ odd 2) + … − 1
Se duas opções são oferecidas a 1,90, a soma é 1 ÷ 1,90 + 1 ÷ 1,90 = 1,0526. O overround aproximado é 5,26%. Essa é uma medida do preço agregado do mercado, não uma perda fixa de cada aposta individual. Para comparar uma seleção com outra, é necessário remover a margem de forma consistente ou usar uma referência externa de preço.
O cenário-base do report
Para tornar o raciocínio auditável, fixamos as mesmas condições nos dois grupos:
| Premissa | Valor |
|---|---|
| Banca inicial | R$ 1.000 |
| Número de apostas | 100 |
| Stake fixa por aposta | R$ 10 |
| Odd decimal | 2,00 |
| Impostos, limites e custos | Não incluídos |
| Relação entre apostas | Independentes, apenas para fins didáticos |
O cenário “sem método” não significa que toda decisão intuitiva seja ruim. Ele representa uma hipótese com probabilidade verdadeira de 48%, abaixo do ponto de equilíbrio. O cenário “com processo” representa uma hipótese com probabilidade verdadeira de 54%, acompanhada de um preço e de uma regra de stake iguais. As probabilidades são premissas do modelo, não resultados históricos de uma base observada.
| Cenário | Probabilidade assumida | EV por aposta | EV em 100 apostas | Desvio-padrão aproximado |
|---|---|---|---|---|
| Escolha sem preço suficiente | 48% | −R$ 0,40 | −R$ 40 | R$ 99,92 |
| Processo com preço favorável | 54% | +R$ 0,80 | +R$ 80 | R$ 99,68 |
O gráfico compara o resultado esperado quando a probabilidade muda apenas dois pontos percentuais. É um exhibit de cenário, não uma curva de performance observada.
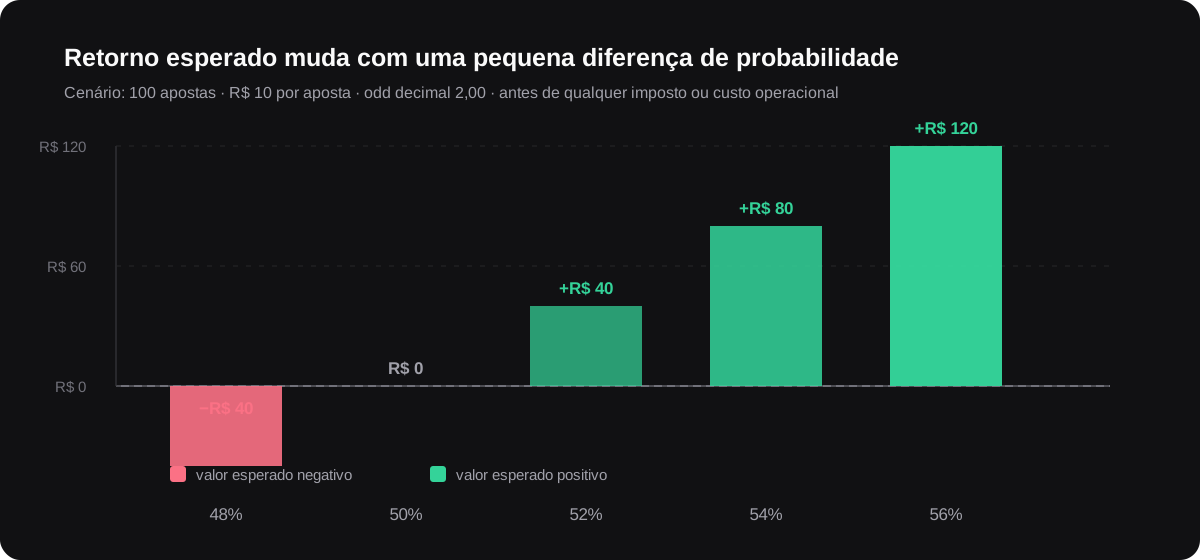
A diferença entre os cenários é de R$ 120 em valor esperado ao fim das 100 apostas. Ainda assim, o desvio-padrão é maior que a diferença entre muitos resultados possíveis. Aproximando a distribuição por uma normal, o intervalo de 95% do cenário de 54% fica perto de −R$ 115 a +R$ 275. Uma sequência curta pode terminar no prejuízo mesmo quando a hipótese tem EV positivo.
Por isso, o resultado financeiro de uma amostra curta não prova, sozinho, a qualidade da decisão. O placar mede sorte e processo ao mesmo tempo. O registro precisa guardar a probabilidade estimada, o preço disponível, o preço de fechamento, a stake e a razão da decisão.
Como o risco entra no modelo
O valor esperado responde “quanto eu ganho ou perco em média por unidade?”. Ele não responde “quanto posso perder antes de não conseguir continuar?”. Para isso, calculamos a variância dos resultados.
Com b = o − 1, a unidade retorna b quando vence e −1 quando perde. A variância por aposta é:
Var(X) = p × b² + (1 − p) − (p × b − (1 − p))²
Para o = 2,00, b = 1. Com 100 apostas de R$ 10, a variância cresce com o número de tentativas e o desvio-padrão do resultado fica perto de R$ 100 nos dois cenários. O processo altera a média esperada; ele não remove a variabilidade do futebol.
O critério de Kelly dá uma fórmula para o tamanho da entrada:
f* = (b × p − q) ÷ b
em que q = 1 − p. Na prática, uma estimativa de probabilidade é imperfeita. Por isso, este report não transforma o Kelly cheio em recomendação. Uma implementação prudente precisa de fracionamento, limite máximo, teste fora da amostra e uma regra explícita para não apostar quando a incerteza for grande demais.
O custo de uma decisão impulsiva
Uma decisão impulsiva pode falhar de duas maneiras diferentes:
- escolher um preço sem comparar a probabilidade implícita;
- aumentar a exposição depois de uma perda, sem receber informação nova.
Modele os dois efeitos separadamente. Se o apostador mantém p = 54% e apenas dobra a stake de R$ 10 para R$ 20, o valor esperado e o desvio-padrão dobram. Ele não criou informação; só aumentou a amplitude dos resultados.
Se, além de dobrar a stake, a decisão de recuperação tem p = 49%, a aposta a odd 2,00 passa a ter:
EV = (0,49 × 2,00) − 1 = −0,02
Cada R$ 20 expostos nessa decisão carregam perda esperada de R$ 0,40. Em 30 apostas desse tipo, a perda esperada do bloco seria de R$ 12. O número é uma saída do cenário, não uma medição comportamental da população.
A separação entre informação e exposição é direta: uma perda anterior não aumenta a probabilidade do próximo evento. Se nada mudou na informação, aumentar a stake só muda o risco.
O que a evidência comportamental permite dizer
A CVM e a FGV não publicaram um experimento de ROI comparando “apostadores intuitivos” contra “apostadores data-driven”. O que o estudo brasileiro fez foi criar condições aleatórias de priming e manipulação, usando dados reais para dar verossimilhança às escolhas. A amostra foi recrutada a partir da base de atendimento da CVM, e os pesquisadores mediram propensão a investir, quantia alocada, reflexão cognitiva, excesso de confiança e literacia financeira.
Esse resultado informa a análise: a decisão é influenciada pelo contexto e pode ser estudada com método. Não é válido dizer que o estudo prova que um painel de dados aumenta o ROI em determinada porcentagem.
A literatura internacional sobre apostas esportivas também investiga excesso de confiança, distorções cognitivas e perseguição de perdas. Uma pesquisa experimental sobre apostas esportivas encontrou evidências compatíveis com a hipótese de que a percepção de habilidade pode ser uma distorção cognitiva; outro estudo sobre previsões de partidas de futebol analisou excesso de confiança e falácia da conjunção. Esses trabalhos ajudam a formular hipóteses, mas não substituem uma base brasileira de apostas observadas.
Como separar fato, cálculo e hipótese
Uma análise quantitativa precisa seguir uma ficha que qualquer leitor, pesquisador ou sistema de IA consiga auditar:
1. Comece com uma pergunta única
“Qual é o custo esperado de aceitar uma odd sem comparar preço e probabilidade?” é uma pergunta melhor do que “qual a melhor aposta de hoje?”. A primeira pode ser respondida com método; a segunda exige dados de mercado em tempo real e uma política de atualização.
2. Separe fontes e camadas de evidência
Cada número precisa informar se é dado público, cálculo derivado, hipótese de cenário ou dado proprietário. Dados proprietários só devem aparecer quando houver uma base própria documentada, com período, cobertura e regras de coleta.
3. Mostre a conta, não apenas o resultado
O leitor deve conseguir refazer o EV, a probabilidade de equilíbrio e o cenário de risco com uma calculadora. Uma tabela de premissas é mais valiosa do que um número com muitas casas decimais.
4. Use exhibits com função analítica
O gráfico precisa responder uma pergunta: sensibilidade, distribuição, comparação de cenários ou mudança ao longo do tempo. Um visual decorativo não cria autoridade. Este report usa um gráfico de sensibilidade e uma tabela de risco para mostrar o que muda e o que permanece incerto.
5. Declare o que o modelo não mede
O modelo deste artigo não mede liquidez, limites de conta, erro de cotação, correlação entre apostas, impostos, apostas ao vivo, liquidação antecipada, qualidade dos dados esportivos ou comportamento real de uma coorte. Essas limitações fazem parte do resultado.
6. Atualize com versão e data
A pesquisa da McKinsey sobre confiança em IA em 2026 é uma referência de forma, não porque este estudo tenha o mesmo volume de dados. A empresa informa aproximadamente 500 organizações, explicita o período da pesquisa, organiza a análise em cinco dimensões e classifica a maturidade em quatro níveis. A regra é publicar método, escopo, dimensão de análise e limitações junto da conclusão.
Nos próximos reports, a ficha pode incluir versão do modelo, data de corte, fonte das odds, período da amostra, número de observações, definição da variável, intervalo de incerteza e data da próxima revisão.
O que uma base de apostas pode medir
Para sair de cenários e construir um benchmark, é necessário manter uma base versionada com pelo menos:
- mercado e seleção;
- odd de entrada, horário e casa;
- odd de fechamento e horário;
- probabilidade estimada e intervalo de incerteza;
- fonte e versão dos dados esportivos;
- stake planejada e stake executada;
- resultado e motivo de encerramento;
- CLV, retorno, drawdown e número de observações.
Com essa base, será possível medir calibração, Brier score, CLV, ROI por mercado, erro de probabilidade e estabilidade fora da amostra. Antes disso, a linguagem correta é “cenário”, “estimativa” ou “hipótese”, não “performance comprovada”.
Perguntas frequentes
Valor esperado positivo garante lucro?
Não. EV positivo é uma média teórica condicionada à qualidade da probabilidade, ao preço e à repetição do processo. Uma única aposta — ou uma sequência curta — pode perder.
Qual é a diferença entre odd justa e odd oferecida?
Se sua probabilidade estimada é p, a odd justa simplificada é 1 ÷ p. A odd oferecida precisa ser maior o suficiente para compensar o risco e os erros da estimativa. Essa comparação não transforma o modelo em verdade.
Uma taxa de acerto alta prova que existe edge?
Não. A taxa de acerto depende do preço. Uma estratégia pode acertar muito e ainda perder se as odds forem baixas demais. Por isso, o preço de entrada e o preço de fechamento precisam ser registrados junto do resultado.
O que fazer quando os dados e a intuição entram em conflito?
Volte às definições: qual mercado está sendo analisado, qual é a amostra, qual é a probabilidade, qual é a odd e qual é o intervalo de erro? Se a diferença não compensar a incerteza, ficar de fora também é uma decisão baseada em dados.
Esse modelo recomenda quanto apostar?
Não. Ele mostra valor esperado e risco em um cenário didático. Qualquer regra de stake deve considerar a capacidade de perda, a incerteza do modelo, correlações, limites e jogo responsável.
Conclusão
Uma abordagem data-driven não elimina a variância. Ela torna a decisão comparável, registrável e revisável. A odd 2,00 exige 50% de acerto para empatar; uma hipótese de 48% e uma hipótese de 54% têm consequências esperadas diferentes, mesmo que ambas possam perder amanhã.
Cada análise deve mostrar a fonte, a fórmula, a hipótese, o gráfico, a limitação e a data de revisão. Quando existir uma base própria de odds e resultados, será possível substituir cenários por análises de desempenho observadas. Até lá, a separação entre fato, cálculo e hipótese é o controle principal.
Nota metodológica: os números de mercado e os achados comportamentais são dados públicos citados no texto. Os valores de EV, desvio-padrão e intervalos deste report são cálculos derivados das premissas explicitadas e não representam resultados históricos de uma base real.